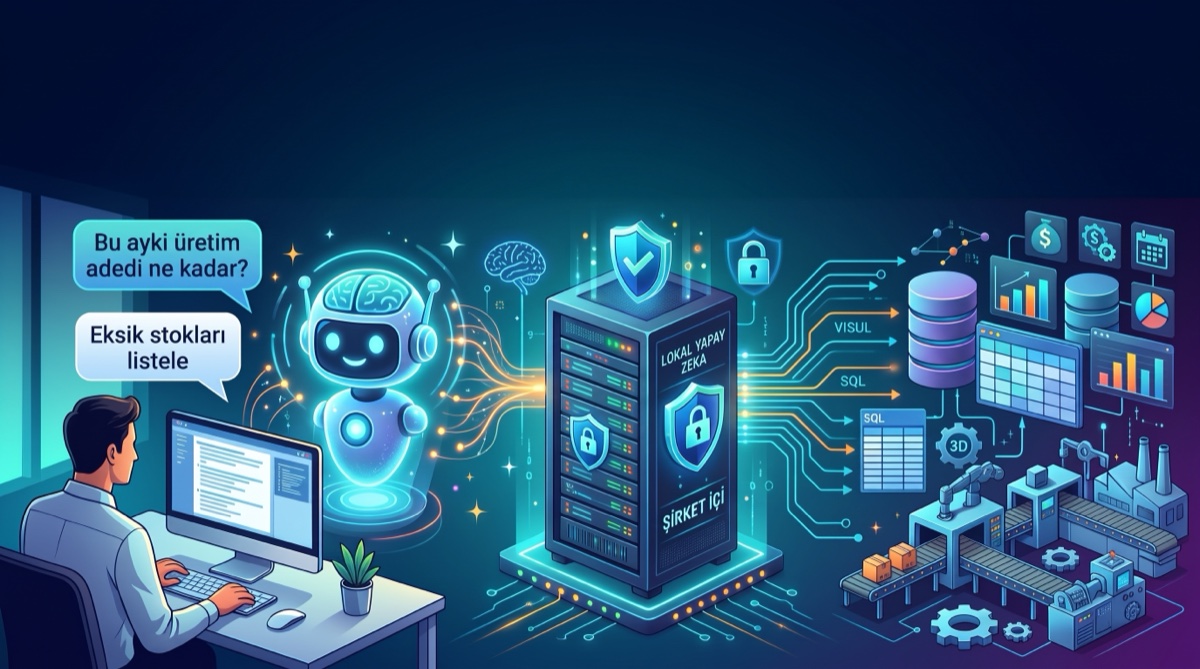
Bir işletmede ERPSipariş, stok, muhasebe ve üretim planlama süreçlerini tek bir veritabanında birleştiren kurumsal yazılım sistemi.Sözlükte detaylı bilgi → veya MESÜretim sahasındaki makine, operatör ve süreç verilerini gerçek zamanlı olarak toplayan ve yöneten yazılım sistemi.Sözlükte detaylı bilgi → yatırımı genellikle tek soruyla ölçülür: “Sistem çalışıyor mu?” Asıl sorulması gereken soru farklıdır: Sistemde biriken veri, karar verenlerin eline ne kadar ulaşıyor? Veri yıllardır birikiyor; ama çoğu işletmede yalnızca rapor yazabilen birkaç kişinin okuyabildiği bir arşiv olarak duruyor.
Bu soruyu kendi elimizle denemek istedik: işletme veritabanına Türkçe soru sorulabilen ve tamamen şirket içinde çalışan bir yapay zekaVeriden örüntü öğrenip tahmin, sınıflandırma ya da metin üretimi yapan yazılım; üretimde rapor, bakım ve kalite kararlarına yardımcı olur.Sözlükte detaylı bilgi → asistanı kurduk. Seçtiğimiz yaklaşım, sistemin kurgusu, modeli işletmeye tanıtma biçimimiz ve gerçek kullanıcıların önünde gördüklerimiz aşağıda.
Sorun verinin azlığı değil, dili
ERP ve MES tablolarla, kodlarla ve sorgularla konuşur; yönetici cümlelerle düşünür. Hazır raporda olmayan her soru bilgi işlem ekibine yeni bir iş olarak düşer ve sıraya girer. Sıradaki iş bittiğinde soru çoğu zaman eskimiştir.
Yapay zekanın bu iki dil arasında tercümanlık yapabileceğini düşünüyoruz. Beklediğimiz kazanımlar şunlar:
- Daha fazla kişi soru sorabilir. SQL bilmeyen kullanıcı da kendi cümlesiyle veriye ulaşmayı dener.
- Cevaba daha hızlı ulaşılır. Rapor talebi, bekleme ve Excel düzenleme adımları kısalır.
- Bilgi işlemin yükü hafifler. Tekrar eden basit rapor talepleri azalır.
- Kurum hafızası yazılı hale gelir. İş kuralları birkaç kişinin kafasında değil, ortak bir rehberde durur.
İlk üçü sistemin işe yaradığı ölçüde gerçekleşir. Dördüncüsü, aşağıda anlatacağımız gibi, sistem hiç çalışmasa bile elde kalan kazanımdır.
Yaklaşım: Doğal dilden sorguya, şirket içinde
Denediğimiz yaklaşım literatürde “text-to-SQLKullanıcının Türkçe sorusunu dil modeliyle veritabanı sorgusuna çeviren, sonucu tekrar doğal dile döken yaklaşım.Sözlükte detaylı bilgi →” diye geçer: kullanıcı soruyu kendi cümlesiyle yazar, dil modeliBüyük metin kütlesinden öğrenmiş, doğal dildeki soruyu anlayıp metin ya da veritabanı sorgusu üreten yapay zeka modeli.Sözlükte detaylı bilgi → bu soruyu bir veritabanı sorgusuna çevirir, sorgu çalışır ve sonuç tekrar Türkçeye dönüştürülür.
Burada bilinçli bir tercih yaptık. Bulut tabanlı bir yapay zeka servisi yerine şirket içinde çalışan, açık kaynaklı ve görece küçük bir dil modeli kullandık. Model şirket sunucusunda çalışıyor ve mevcut veritabanına, sistemde herhangi bir değişiklik yapılmadan bağlanıyor. Kullanıcı tarayıcı üzerinden, bir sohbet ekranında soru soruyor.
Bu tercihin arkasında üç beklenti var. Veri şirket dışına çıkmıyor, çünkü hiçbir bilgi harici bir sunucuya gönderilmiyor. Maliyet öngörülebilir, çünkü soru başına ücret ödenmiyor. Kontrol işletmede kalıyor, çünkü sistemin davranışı bir servis sağlayıcının güncellemesiyle bir gecede değişmiyor.
Bedeli de açık: küçük bir lokal modelBulut servisine değil şirketin kendi sunucusuna kurulan yapay zeka modeli; veri dışarı çıkmaz, soru başına ücret ödenmez.Sözlükte detaylı bilgi →, büyük bulut modelleri kadar güçlü değil. Bu yüzden sistemi, modelin iyi yaptığı işe odaklanacağı, geri kalanın yazılımla güvence altına alınacağı biçimde kurguladık. Cevapların tutarlı olması için modelin “yaratıcılık” payını en aza indirdik; bu, aynı soruya her zaman birebir aynı cevabı garanti etmiyor ama değişkenliği belirgin biçimde azaltıyor.
Bir sorunun yolculuğu
Kullanıcının yazdığı bir cümle, cevaba dönüşene kadar birkaç aşamadan geçiyor. Her aşamanın tek bir görevi var ve hiçbir aşama bir öncekine körü körüne güvenmiyor. Hatalı ya da güvensiz bir sorgu kullanıcıya ulaşmadan modele geri dönüyor; düzeltme hakkı en fazla üç deneme.
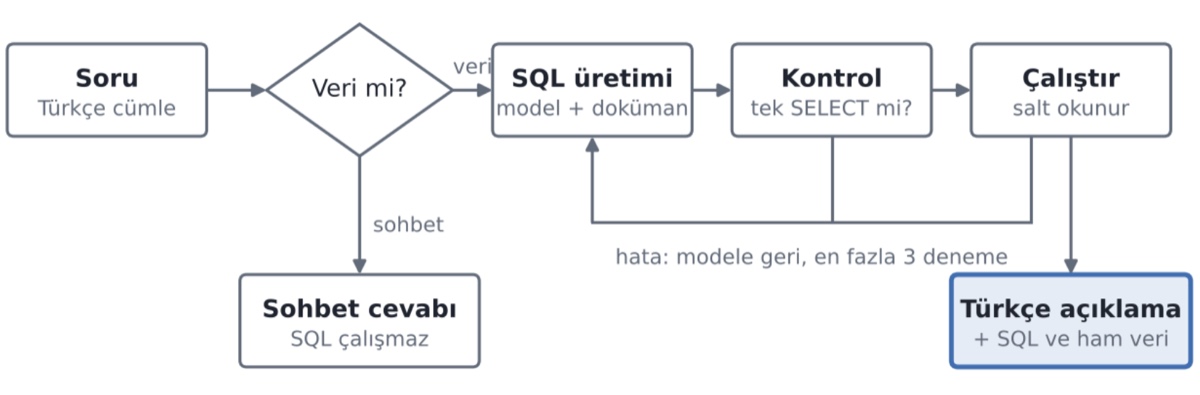
- Niyet tespitiKullanıcı mesajının veri sorusu mu, selamlaşma gibi sohbet mi olduğuna karar veren ön kontrol; sohbet için veritabanına gidilmez.Sözlükte detaylı bilgi →. Kısa bir ön kontrol, mesajın bir veri sorusu mu yoksa selamlaşma, teşekkür gibi bir sohbet mesajı mı olduğuna karar verir. Sohbet mesajı için veritabanına gidilmez.
- Sorgu üretimi. Model; soruyu, tablo rehberini ve varsa bir önceki soruyu birlikte okuyarak tek bir okuma sorgusu yazar. Önceki sorunun bağlamı, kullanıcının bir sonucu adım adım daraltabilmesi, gruplayabilmesi ya da sıralayabilmesi için verilir.
- Söz dizimi ve güvenlik kontrolü. Sorgu veritabanına gitmeden önce yazılım tarafından denetlenir: tek bir ifade mi, gerçekten yalnızca okuma mı yapıyor?
- Çalıştırma. Sorgu, yalnızca okuma yetkisi olan bir kullanıcıyla ve süre sınırı altında çalışır.
- Hata döngüsü. Veritabanı hata döndürürse hata mesajı modele geri gönderilir ve sorguyu düzeltmesi istenir.
- Açıklama. Sonuç tablosu kısa bir Türkçe özetle gösterilir. Toplamlar ve sayılar yazılım tarafından hesaplanır; model yalnızca hazır sayıları yorumlar. Kullanılan sorgu ve ham veri, isteyen kullanıcı için açılabilir bir bölümde durur.
Modeli işletmeye tanıtmak: tablo rehberi
Bir dil modeli sorgu dilini bilir; ama işletmenizin “açık sipariş” derken neyi kastettiğini bilemez. Bu bilgi tablo adlarında yazmaz, işletmenin hafızasındadır. Bu yüzden modele veritabanının kendisini değil, iş kurallarıyla zenginleştirilmiş bir tablo rehberi verdik.
Rehberi, yazılımcı olmayan iş birimi uzmanlarının da okuyup düzenleyebileceği biçimde hazırladık; çünkü kuralı en iyi bilen kişi çoğu zaman yazılımcı değil, işi her gün yapan kişidir. Her konu için (sipariş, stok, cari…) ayrı bir bölüm var ve her bölüm şunları anlatıyor:
- Alanlar ve anlamları. Hangi alan ne tutar, hangi değerleri alabilir?
- Durum kuralları. “Açık”, “onaylı”, “iptal” gibi kavramların hangi koşula karşılık geldiği.
- Tablolar arası bağlantılar. Hangi tablonun hangisine, hangi alanla bağlanacağı.
- Terimler sözlüğü. Kullanıcının ağzındaki ifadenin veritabanındaki karşılığı; “ciro” denince hangi hesabın yapılacağı gibi.
- Örnek sorgular ve sık yapılan hatalar. Doğru sorgunun nasıl göründüğüne dair birkaç örnek ve kaçınılması gereken yaygın tuzaklar.
Bu rehber bir kerelik iş değil. Sistem kullanıldıkça eklenen her yeni kural rehberi büyütüyor; elde kalan şey, iş kurallarının tek yerde yazılı olduğu bir kurum hafızası. Yukarıda “sistem hiç çalışmasa bile” dediğimiz kazanım bu.
Güvenlik: modele güvenmek zorunda kalmamak
Modelin yanlış ya da zararlı bir sorgu yazabileceğini baştan kabul ettik ve sistemi buna göre kurduk. Korumayı tek bir noktaya bırakmak yerine üst üste binen katmanlarla sağlıyoruz:
- Yetki katmanı. Uygulama veritabanına yalnızca okuma yetkisi olan ayrı bir kullanıcıyla bağlanır. Model bir silme komutu yazsa bile veritabanı bunu reddeder. Bu kullanıcının hangi tabloları görebileceğinin de veritabanı yetkileriyle sınırlanması, bize göre asıl güvencedir.
- Kod katmanı. Birden fazla ifade içeren ya da okuma dışında bir işlem yapan sorgu veritabanına hiç ulaşmaz.
- Performans katmanı. Sorguların canlı sistemdeki kullanıcıların işlemlerini bekletmemesi için kayıt kilitlemeyen bir okuma modu seçtik; bunun, o an yazılmakta olan kayıtlarda küçük anlık tutarsızlıklara yol açabileceğini kabul ediyoruz. Her sorguya süre ve satır sınırı uygulanır.
- BağlamDil modelinin cevap verirken gördüğü bilgi penceresi: soru, tablo rehberi, varsa önceki soru ve sorgusu.Sözlükte detaylı bilgi → katmanı. Model yalnızca rehberde tanıtılan tabloları hedef alacak şekilde yönlendirilir. Bu tek başına bir güvenlik önlemi değil, yetki katmanını tamamlayan bir düzenlemedir.
Bağlantı hatalarını sorgu hatalarından ayrı tutuyoruz: sunucuya ulaşılamıyorsa model boşuna düzeltme denemesi yapmaz, kullanıcıya sorunun bağlantıda olduğu söylenir.
Sahadan gözlemler: nerede zorlandık, ne öğrendik?
İlk denemeler umut vericiydi. Sistem gerçek kullanıcıların gerçek sorularıyla karşılaştığında ise test ortamında görmediğimiz durumlar çıktı. Beşini, olması gerektiğini düşündüğümüz davranışla ve bugün vardığımız noktayla birlikte anlatıyoruz.
1. Sayısal özetlerde hata
Model, sonuç tablosunu özetlerken toplamları ve kayıt sayılarını kendisi hesaplamaya kalktığında zaman zaman yanlış rakam verdi; üstelik bunu büyük bir özgüvenle yaptı. Dil modelleri kelimelerde güçlü, aritmetikte zayıf. Hesap yazılımın, yorum modelin işi olmalıydı.
Toplamlar ve sayılar artık yazılım tarafında hesaplanıp modele hazır veriliyor. O günden beri özetlerdeki rakamın tablodaki rakamdan saptığını görmedik. Beş gözlemin en temiz kapananı bu.
2. Tablolar arası bağlantılarda kayıtların çoğalması
Bazı tablolarda aynı ana kayda bağlı birden fazla alt kayıt bulunur. Model tabloları bu ayrıntıyı bilmeden birleştirdiğinde satırlar çoğaldı ve toplamlar olduğundan büyük çıktı. Farklı para birimlerindeki tutarların tek toplamda birleştirildiği de oldu. Veritabanı her iki durumda da hata vermedi; sorgu geçerliydi, sonuç yanlıştı.
Doğru bağlantı koşulu ve “hangi tutarlar birlikte toplanabilir” kuralı modelin tahminine bırakılmamalı, rehberde açıkça yazmalı. Rehberin “sık yapılan hatalar” bölümüne eklenen kurallar bu hataları gözle görülür biçimde azalttı. Ancak rehbere henüz yazılmamış bir kural yine yanlış sonuca yol açabilir; bu alanı izlemeye devam ediyoruz.
3. Veri değerini eksik bilgi sanmak
Modele, rehberde olmayan tablo ve alanlar için uydurma (halüsinasyonDil modelinin olmayan alan, kayıt ya da rakamı özgüvenle üretmesi; sayıların yazılımda hesaplanmasının nedeni.Sözlükte detaylı bilgi →) yapmaması, “bilgi yok” demesi öğretilmişti. Kural uydurma alan adlarını büyük ölçüde engelledi; ama kullanıcı soruda bir müşteri adı ya da ürün kodu geçirdiğinde, model bu değeri rehberde bulamayınca yine “bilgi yok” diyebildi. Oysa rehber verinin kendisini değil, yapısını anlatır; sorudaki bir isim ya da kod rehberde değil veritabanında aranmalı.
Talimatlarda yapı ile değer arasındaki fark açıkça yazıldı; model yine de “bilgi yok” derse sistem bir kez itiraz edip yeniden deniyor. Yanlış retler azaldı; tamamen bitti diyemiyoruz.
4. Devam sorularında bağlamın kaybolması
Kullanıcılar bir sonucu adım adım daraltmayı seviyor: önce genel bir liste, ardından “peki sadece şunlar?” gibi bir devam sorusu. Küçük model devam sorusunu çoğu zaman bağımsız bir soru gibi ele alıp önceki filtreleri unuttu.
Önceki soru ve sorgusu modele açıkça verildiğinde ve devam ifadeleri tanındığında, tek adımlık daraltmalarda sonuç iyileşti. Uzun soru zincirlerinde küçük bir modelden kusursuz sonuç beklemek gerçekçi değil; bunu çözmüş değiliz. Kullanılan sorgunun görülebilmesi teknik kullanıcı için bir güvence sağlıyor. Teknik olmayan kullanıcıya sonucun doğru olup olmadığını nasıl göstereceğimizi ise henüz bilmiyoruz; arayış sürüyor.
5. Boş sonuçların yanlış yorumlanması
Filtreye uyan kayıt bulunmadığında model boş bir tabloyu yorumlamaya çalışıp anlamsız cümleler kurdu. Boş sonuç modele sorulacak bir durum değil; yazılımın doğrudan tanıyıp kullanıcıya açıkça söylemesi gereken bir durum. Artık boş sonuçta model hiç çağrılmıyor; kullanıcıya kayıt bulunamadığı söyleniyor ve kullanılan sorgu gösteriliyor.
Beş gözlemin ortak dersi
Yazılımla güvence altına alınabilen sorunlarda kalıcı iyileşme gördük. Rehberin kalitesine ve modelin yorumuna bağlı olanlar iyileşti ama takip istiyor. En dikkatli olunması gereken yer, veritabanının hata vermediği ama anlamca yanlış olan sonuçlar; bunları yakalamanın tek yolu rehberi sürekli geliştirmek ve sonuçları zaman zaman uzman gözüyle kontrol etmek.
Buradan çıkardığımız ilke kısa: modele yalnızca iyi yaptığı işi verin, gerisini yazılımla güvence altına alın.
Haklı olarak şu denebilir
“Bu kadar katman, bu kadar rehber… Rehbere her kuralı zaten yazıyorsanız, raporu da yazın bitsin. Model ne iş yapıyor?” Rehber bir kez, konu başına yazılır; sorular ise sınırsızdır. Sipariş bölümü bir kez doğru anlatıldığında “bu ay hangi müşteriye kaç sipariş açıldı”, “geçen yıl aynı ayla farkı ne”, “bunların kaçı termini geçti” sorularının her biri için ayrı rapor yazılmaz. Rapor, cevabı önceden bilinen soruya yazılır; model, henüz sorulmamış soru için var.
İkinci itiraz daha ciddi: “Sonucun yanlış olduğunu kullanıcı nasıl anlayacak?” Bunun teknik kullanıcı için cevabı var, teknik olmayan kullanıcı için henüz yok. Yukarıda açıkça yazdık.
Nereden başlamalı?
Bu tür bir deneme için büyük bir proje başlatmak gerekmez. Bize göre en sağlıklı yol küçük başlamak:
- En çok soru gelen alanı seçin. Çoğu işletmede bu, sipariş ve stok verisidir.
- Bu alandaki tabloları ve kuralları, işi her gün yapan kişilerle birlikte rehbere dökün.
- Önce kontrollü bir ortamda deneyin, ardından şirket sunucusuna taşıyın.
- Küçük bir kullanıcı grubuyla başlayın; güven oluştukça kapsamı genişletin.
- Hangi kullanıcının hangi veriye soru sorabileceğini baştan belirleyin.
Asıl kazanç: veriyle konuşan bir işletme
“Ürün Bazında Enerji Maliyeti” makalesinde her hafta aynı üç soruya dönmekten söz etmiştim: Hedeften ne kadar uzağız? Neden? Ne yapacağız? O rutini kıran şey çoğu zaman isteksizlik değil, cevabın bir rapor talebinin arkasında olmasıdır. Yapay zekanın ERP ve MES verisine katabileceği en büyük değer, bize göre yeni bir rapor değil, yeni bir alışkanlık: merak edilen şeyin sorulması ve cevabına kısa sürede ulaşılması. Üstelik bunu veriyi şirketin dışına çıkarmadan denemek mümkün.
Veri veritabanında duruyor ama ona ulaşmak için birini bekliyorsanız, o verinin değeri henüz ortaya çıkmamıştır.
Cevabı için birini beklediğiniz veri, henüz karar verisi değildir.
Tolga Yıldız
LinkedIn ProfiliYorumlar
Yorum yapmak için giriş yapmanız gerekiyor.
Yorumlar yükleniyor…